Как читать аутосомный тест Family Finder
Справочник: что такое сантиморган, почему сумма общих сантиморганов не называет родство однозначно, как по хромосомному браузеру и матрице развести материнскую и отцовскую стороны, почему у половины «четвероюродных» из списка нет с вами вообще никакого родства и отчего одна и та же пара людей получает у двух лабораторий разные цифры.
Иллюстрации — фрагменты моего личного кабинета в FamilyTreeDNA и в Генотеке, снимки августа 2026 г. Имена совпаденцев заменены на роли: Мать, Совпаденец А…К, Дальний 1…5, Европеец 1…7. Подпись всюду означает одного и того же человека, так что его можно проследить из списка в матрицу, в хромосомный браузер и в чужую лабораторию.
Весь справочник одним файлом для печати: PDF, 37 страниц.
1. Что такое Family Finder и чего от него ждать
Наш геном включает 22 пары аутосом (неполовых хромосом). Каждая пара формируется просто: одна хромосома достаётся от матери, вторая — от отца.
Однако внукам они передаются уже смешанными. При созревании половых клеток парные хромосомы делятся фрагментами — происходит рекомбинация. Из-за этого ребёнок наследует не исходную хромосому конкретного предка, а сшитую заново мозаику из ДНК дедушки и бабушки.
Отсюда всё остальное:
- От каждого родителя — ровно половина ДНК. Это не среднее, а точная величина.
- От каждого из четырёх дедов и бабок — в среднем четверть, но уже с разбросом.
- Дальше разброс растёт быстро. С конкретным прапрапрадедом (6 поколений) вы делите в среднем около 1,5 % генома, а можете не делить с ним ничего.
Аутосомный тест видит все линии сразу, но неглубоко. Y-хромосома и мтДНК передаются без рекомбинации и работают на тысячи лет, зато каждая описывает ровно одну линию из сотен. Family Finder — наоборот: он охватывает всю родню, но уверенно достаёт примерно до троюродных, а дальше уходит в шум. В селе, где все друг другу дальняя родня, надёжная граница ещё ближе (раздел 12). Про Y-дерево — отдельный справочник этой серии, «Как читать дерево FamilyTreeDNA».
Технически это не чтение генома целиком, а чиповый тест: считываются сотни тысяч заранее выбранных позиций (SNP), в которых люди чаще всего различаются. Между этими позициями прибор не смотрит ничего. Это важно для раздела 10: там, где выбранных позиций мало, алгоритм слепнет.
2. Сантиморган
Общая ДНК меряется в сантиморганах (сМ) — и это не длина.
Сантиморган — единица генетической карты: участок длиной 1 сМ — это участок, на котором при передаче потомству в среднем происходит один разрыв на сто мейозов. Иначе говоря, сМ меряет не «сколько пар оснований», а насколько трудно этот кусок разорвать при передаче. Поэтому один и тот же отрезок в мегабазах у разных участков генома весит разное число сантиморганов: у концов хромосом рекомбинация идёт чаще, у центромер — реже.
Практический вывод: складывать сантиморганы можно, переводить их в проценты — с оговоркой, а сравнивать с физическими координатами напрямую нельзя.
Сколько всего сантиморганов
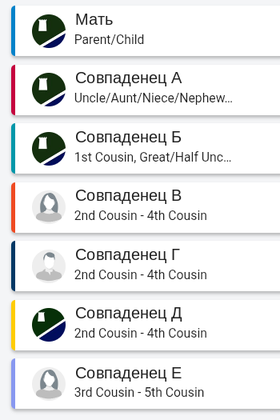
В моём списке есть две независимые пары «родитель — ребёнок»: я и Мать, а также Совпаденец Ж и Совпаденец В (они попали в мои совпаденцы по отдельности, а матрица показала, что они друг другу родитель и ребёнок). Обе пары дают ровно 3567 сМ.
Это не случайное совпадение. Ребёнок получает от родителя по одной полной копии каждой аутосомы, то есть делит с ним всю карту наполовину. Отсюда оценка: полная аутосомная карта у FTDNA — около 7134 сМ. Это мой расчёт по двум парам.
Другие сервисы считают по своим картам и дают свои числа. В сводке из раздела 5, где собраны пары из всех компаний, родитель и ребёнок делят от 2376 до 3720 сМ.
Это первая проверка на вменяемость любого списка совпаденцев: если у «родителя/ребёнка» заметно меньше половины карты, значит, родство другое — или что-то не так с данными.
3. Как FTDNA решает, что вы совпаденцы
Одного жёсткого порога больше нет. В 2021 году FTDNA переписала сравнение (Family Finder Matching 5.0). Теперь так:
- нужен хотя бы один общий сегмент от 7 сМ — это нижняя граница;
- куски короче 6 сМ в сумму не идут;
- настоящий порог выше и у каждой пары свой. Алгоритм смотрит на сумму, на самый длинный блок и на число мелких общих кусков и отсеивает тех, кто похож на ложного совпаденца.
С мая 2016 года совпаденцем считался любой, у кого есть один сегмент от 9 сМ, либо сумма от 20 сМ при самом длинном куске от 7,69 сМ (у одного процента тестировавшихся — от 5,5 сМ). Эти числа до сих пор ходят по форумам и пособиям, но устарели.
Отдельно запомните строчку из описания нового алгоритма: он оценивает эндогамию по россыпи мелких общих кусков, типичной для замкнутых групп. По этой оценке он поднимает порог и сдвигает Relationship Range. В описании названы ашкеназы, индейцы, полинезийцы, финны «и другие». То есть сама компания признаёт: при эндогамии обычные мерки дают мусор. Но поправка уходит в порог и в прогноз родства. Сумма в карточке — это просто сложенные сегменты, и эндогамия её по-прежнему завышает. К этому вернёмся в разделе 12.
Хромосомный браузер рисует по тому же порогу. В выпадающем списке над картинкой два значения: 6+ и 10+ сМ. На 6+ видны ровно те куски, из которых сложена сумма в карточке: короче 6 сМ FTDNA не считает вовсе. На 10+ остаются только длинные, и картинка выглядит беднее суммы. Сверяя карточку с браузером, ставьте 6+.
4. Карточка совпаденца
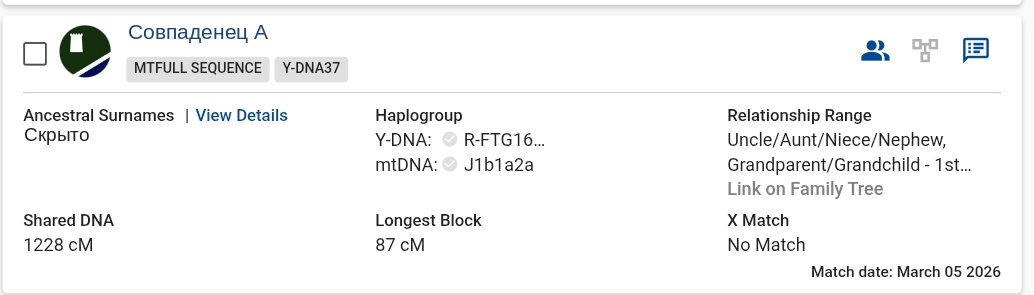
Разберём поля.
Shared DNA — сумма всех общих сегментов в сМ. Главное число, но само по себе оно родство не называет (раздел 5).
Longest Block — самый длинный общий сегмент. Величина важнее, чем кажется: сумму раздувают мелкие куски, а длинный блок в одиночку говорит о близости лучше. Общий предок в N поколениях оставляет длинные куски; чем дальше предок, тем короче обломки.
X Match — общая ДНК на X-хромосоме, отдельной строкой. Единственное поле, которое в некоторых случаях сразу называет сторону родства (раздел 9).
Relationship Range — диапазон родства, оценка алгоритма. Именно диапазон: у Совпаденца А там стоит «Uncle/Aunt/Niece/Nephew, Grandparent/Grandchild — 1st Cousin», то есть четыре разных родства сразу.
Ancestral Surnames — фамилии предков, которые совпаденец вписал сам. Поле необязательное, у многих пусто («Not Provided»). На иллюстрациях я эти значения скрыл: по ним человек находится так же однозначно, как по имени.
Haplogroup — Y-гаплогруппа (только у мужчин) и митохондриальная, если совпаденец сдавал соответствующие тесты. Значки под именем (BIG Y-700, MTFULL SEQUENCE, Y-DNA37) показывают, что именно он сдавал.
Match date — когда совпадение появилось, а не когда человек тестировался.
Вкладки Paternal / Maternal / Both

Над списком: All (496) — столько у меня всего совпаденцев, и рядом Paternal (0), Maternal (0), Both (0).
Нули — не поломка, а наследство. Раскладка работала, когда у FTDNA было собственное дерево на сайте: вы привязывали к нему известную родню, и алгоритм разносил остальных по сторонам. Свой редактор дерева компания закрыла 9 сентября 2024 года: дерево теперь предлагают вести на MyHeritage или привязать к профилю страницу на WikiTree. А вкладки остались.
Рассчитывать на них не стоит: стороны родства придётся разводить руками. Как именно — в разделах 7 и 9.
5. Сколько сантиморганов — какое родство
Ниже — сводка проекта The Shared cM Project (версия 4.0, март 2020, около 60 тысяч заявленных родств, собранных у пользователей всех крупных компаний). Для каждого родства — сколько сМ делили реальные пары: минимум, среднее, максимум.
| Родство | Мин | Среднее | Макс | N пар |
|---|---|---|---|---|
| Родитель / ребёнок | 2376 | 3485 | 3720 | 2412 |
| Родные брат / сестра | 1613 | 2613 | 3488 | 2465 |
| Дядя-тётя / племянник | 1201 | 1741 | 2282 | 2695 |
| Дед-бабка / внук | 984 | 1754 | 2462 | 1106 |
| Единокровные / единоутробные | 1160 | 1759 | 2436 | 1266 |
| Двоюродные (1C) | 396 | 866 | 1397 | 3337 |
| Двоюродные через одного общего предка | 156 | 449 | 979 | 691 |
| Троюродные (2C) | 41 | 229 | 592 | 4172 |
| 2C1R | 14 | 122 | 353 | 5281 |
| Четвероюродные (3C) | 0 | 73 | 234 | 4775 |
| 3C1R | 0 | 48 | 192 | 4514 |
| Пятиюродные (4C) | 0 | 35 | 139 | 2752 |
Русские названия условны: в западной традиции «1C» — дети родных братьев и сестёр (наши двоюродные), «2C» — внуки (наши троюродные) и так далее. Дальше в тексте я пишу английские обозначения, чтобы не путать.
Единокровные — те, у кого общий отец; единоутробные — общая мать. Их часто называют сводными, и это ошибка: сводные — это дети от прежних браков мужа и жены, общей ДНК у них нет вовсе, и друг у друга в списке совпаденцев они не появятся.
И главное: таблицу собрали по семьям без эндогамии. В селе суммы выше табличных — почему и что с этим делать, в разделе 12.
Смотреть в этой таблице надо не на средние, а на перекрытие диапазонов. 1200 сМ попадает одновременно в «дядя», «дед», «полусибсы» и в верхний хвост «двоюродных». Ни одна цифра суммы не выделяет из них ровно одно родство — потому FTDNA и печатает диапазон, а не ответ.
Обратите внимание и на нули в колонке «мин»: у 3C и дальше минимум равен нулю. Настоящий четвероюродный может не делить с вами ничего. Отсутствие человека в списке совпаденцев не означает отсутствия родства.
Мои цифры
| Кто | Shared DNA | Longest Block | X Match | Оценка FTDNA | На самом деле |
|---|---|---|---|---|---|
| Мать | 3567 сМ | 284 сМ | 181 сМ | Parent/Child | мать |
| Совпаденец А | 1228 сМ | 87 сМ | нет | дядя / дед / 1C | сын сестры моего отца |
| Совпаденец Б | 979 сМ | 105 сМ | 39 сМ | 1C / полудядя | сын брата моей матери |
| Совпаденец В | 63 сМ | 30 сМ | нет | 2C – 4C | не установлено |
| Совпаденец Г | 52 сМ | 25 сМ | нет | 2C – 4C | не установлено |
| Совпаденец Д | 46 сМ | 33 сМ | нет | 2C – 4C | не установлено |
Смотрите на две верхние содержательные строки. А и Б — оба мои двоюродные братья, родство одно и то же. А в цифрах: 1228 сМ против 979 сМ, длинный блок 87 против 105, X-совпадение есть у одного и нет у другого. Причём алгоритм у А назвал диапазон «дядя / дед / 1C», а у Б — «1C / полудядя». Одинаковое родство, разные цифры и разные подписи.
По таблице выше двоюродные делят 396–1397 сМ при среднем 866. Оба моих двоюродных брата лежат выше среднего, а А — почти у верхней границы. Это не случайность, и к её причине я вернусь в разделе 12.
Три нижние строки одинаково подписаны «2nd Cousin – 4th Cousin», хотя суммы у них 63, 52 и 46 сМ. Диапазон один и тот же, а реальные родства могут отличаться на два поколения.
6. Хромосомный браузер: как выглядит настоящее родство
Chromosome Browser рисует, где именно лежат общие куски. Каждая хромосома — стопка серых полосок, по одной на выбранного совпаденца; цветом закрашено общее.
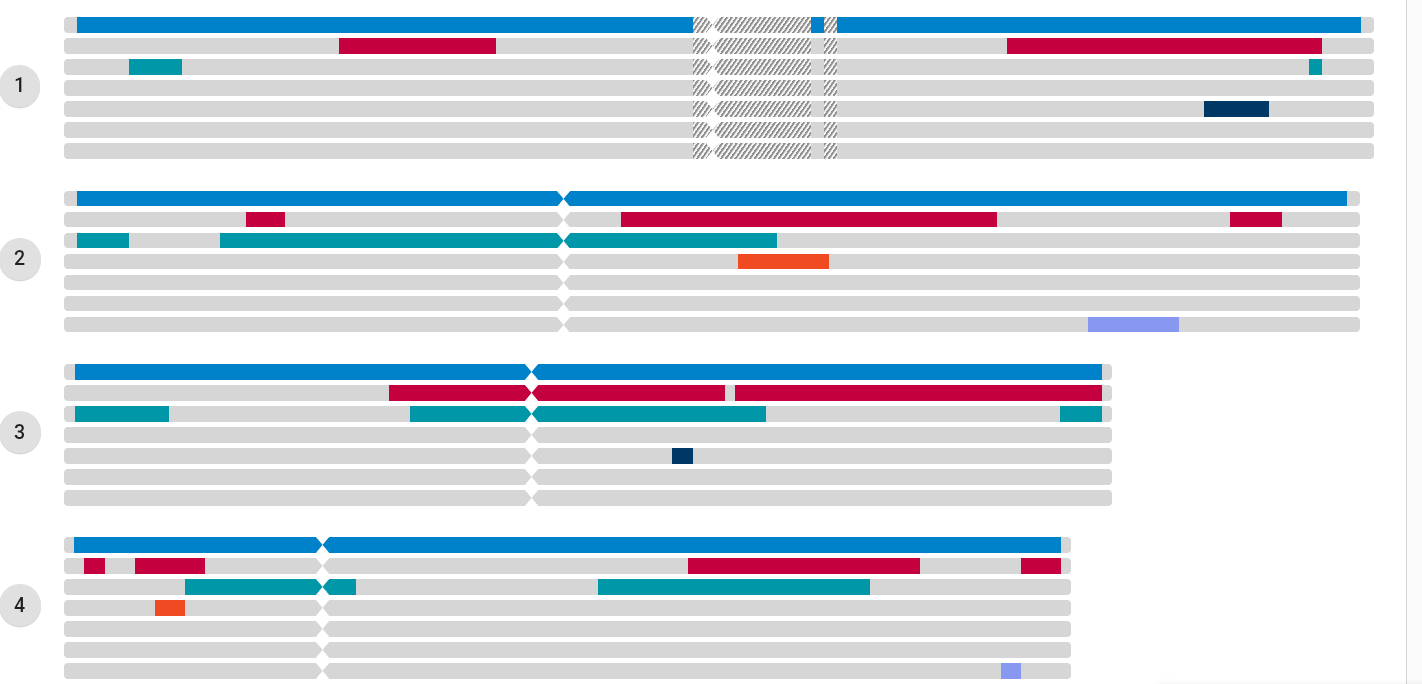
Верхняя полоса в каждой хромосоме — Мать. Она закрашена целиком, от края до края, на всех хромосомах без исключения. Так и должно быть: одна из двух копий каждой хромосомы у меня — материнская целиком, поэтому «общий сегмент» с матерью — это вся хромосома.
Ниже — родня попроще. У Совпаденца А (вторая полоса) на первой хромосоме два больших куска, у Совпаденца Б (третья) — свои, в других местах. Чем дальше родство, тем короче и реже куски.
Уберём мать
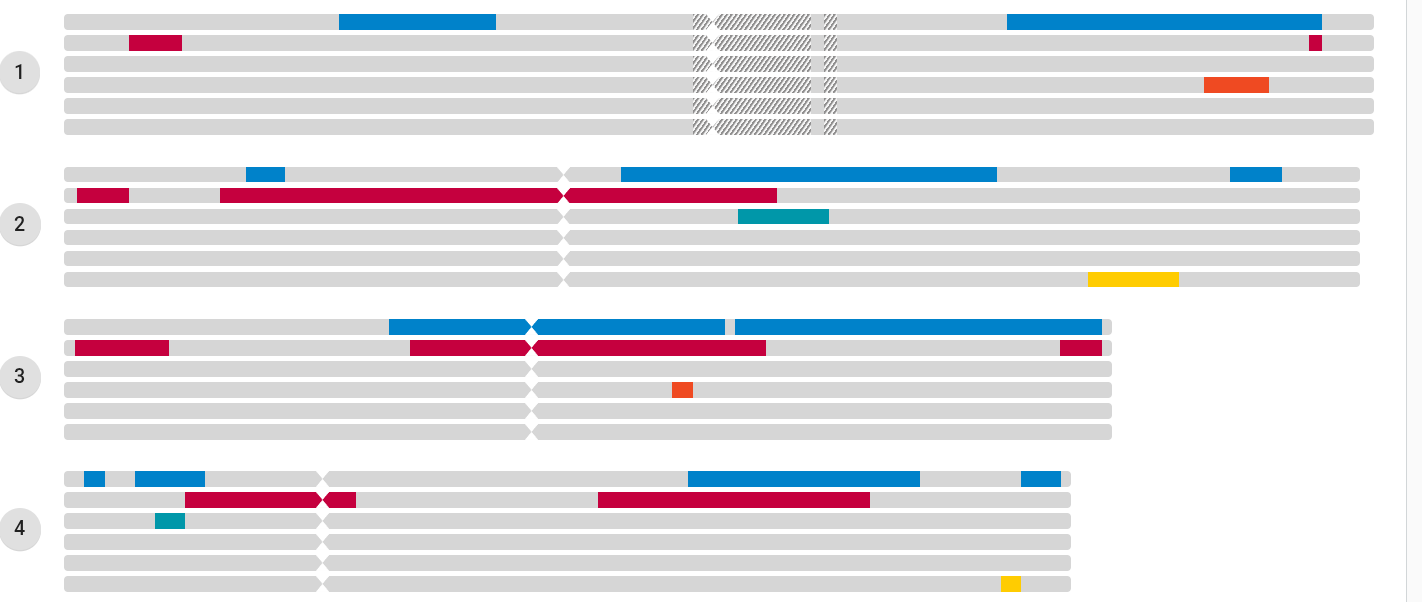
Тот же набор без первой строки. Видно главное свойство настоящих совпаденцев: куски лежат в разных местах и разной длины. Это отпечаток случайной рекомбинации — именно так выглядит родство.
А теперь — «четвероюродные»
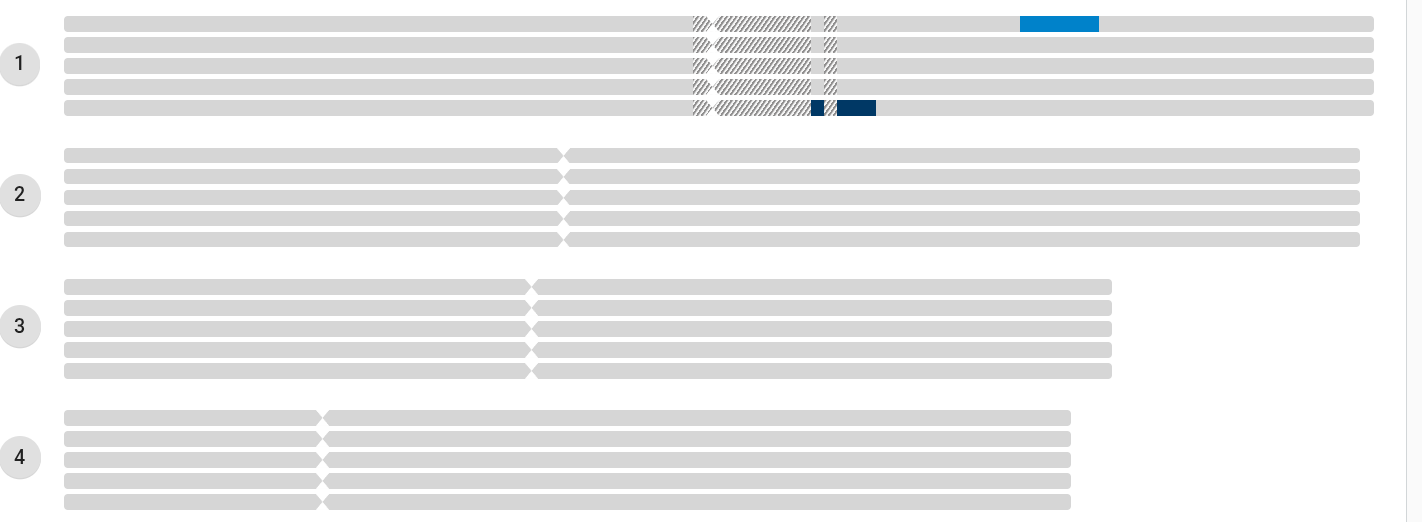
Пять человек из списка с диапазоном 4th Cousin – Remote. На всю первую хромосому — один заметный кусок и пара крошек, дальше по хромосомам пусто. Формально каждый из них — совпаденец; фактически показывать в браузере почти нечего.
Отсюда рабочее правило: сначала браузер, потом выводы. Если общее с человеком не рисуется, обсуждать с ним общего предка рано.
Detailed Segment Data: точные числа
Вторая вкладка того же экрана — Detailed Segment Data. То же самое, но таблицей: хромосома, начало и конец сегмента в парах оснований, длина в сантиморганах и число совпавших SNP.
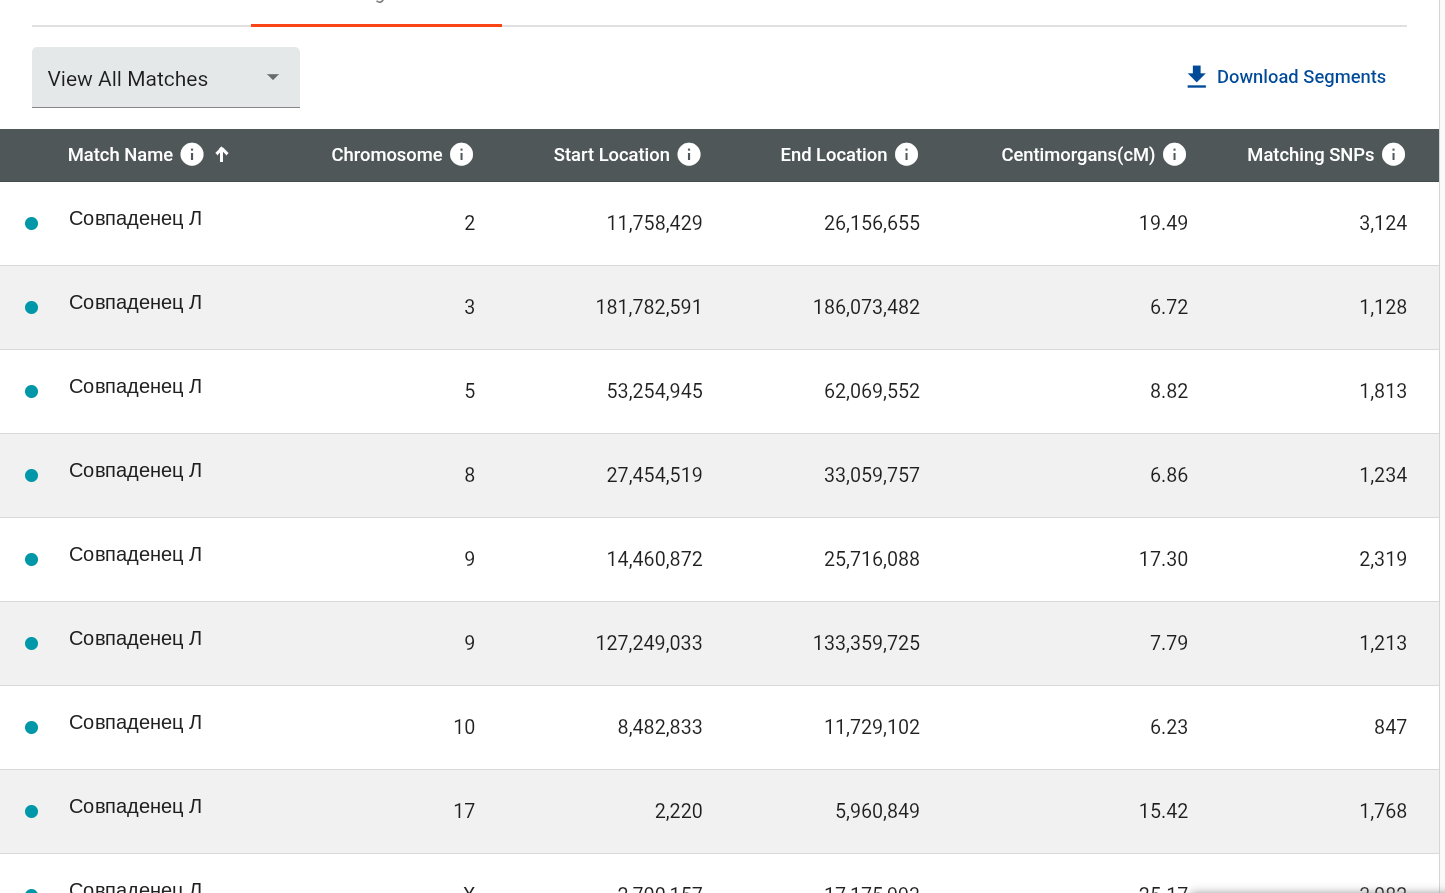
Это единственное место, где числа берутся точно, а не снимаются с картинки. Оттуда же кнопка Download Segments — выгрузить всё файлом.
Три наблюдения прямо из этой таблицы:
- у Матери каждая хромосома идёт одним сегментом во всю длину: первая — от 72 526 до 249 222 527, это 284,04 сМ и 49 280 совпавших SNP. Ровно то, что на картинке выглядит сплошной синей полосой;
- у Совпаденца Л сегментов девять, самый длинный — 19,49 сМ;
- X-хромосома считается отдельно. Восемь аутосомных сегментов Совпаденца Л дают в сумме 88,6 сМ — те самые 89 сМ, что стоят в карточке, — а X-сегмент длиной 25,17 сМ в эту сумму не входит и живёт своей строкой.
7. Матрица «все со всеми»
Самый недооценённый инструмент FTDNA. В списке отмечаете нескольких совпаденцев, внизу появляется панель с кнопкой Compare Matrix, и вы получаете таблицу: сколько сМ каждый из них делит с каждым другим — не с вами.
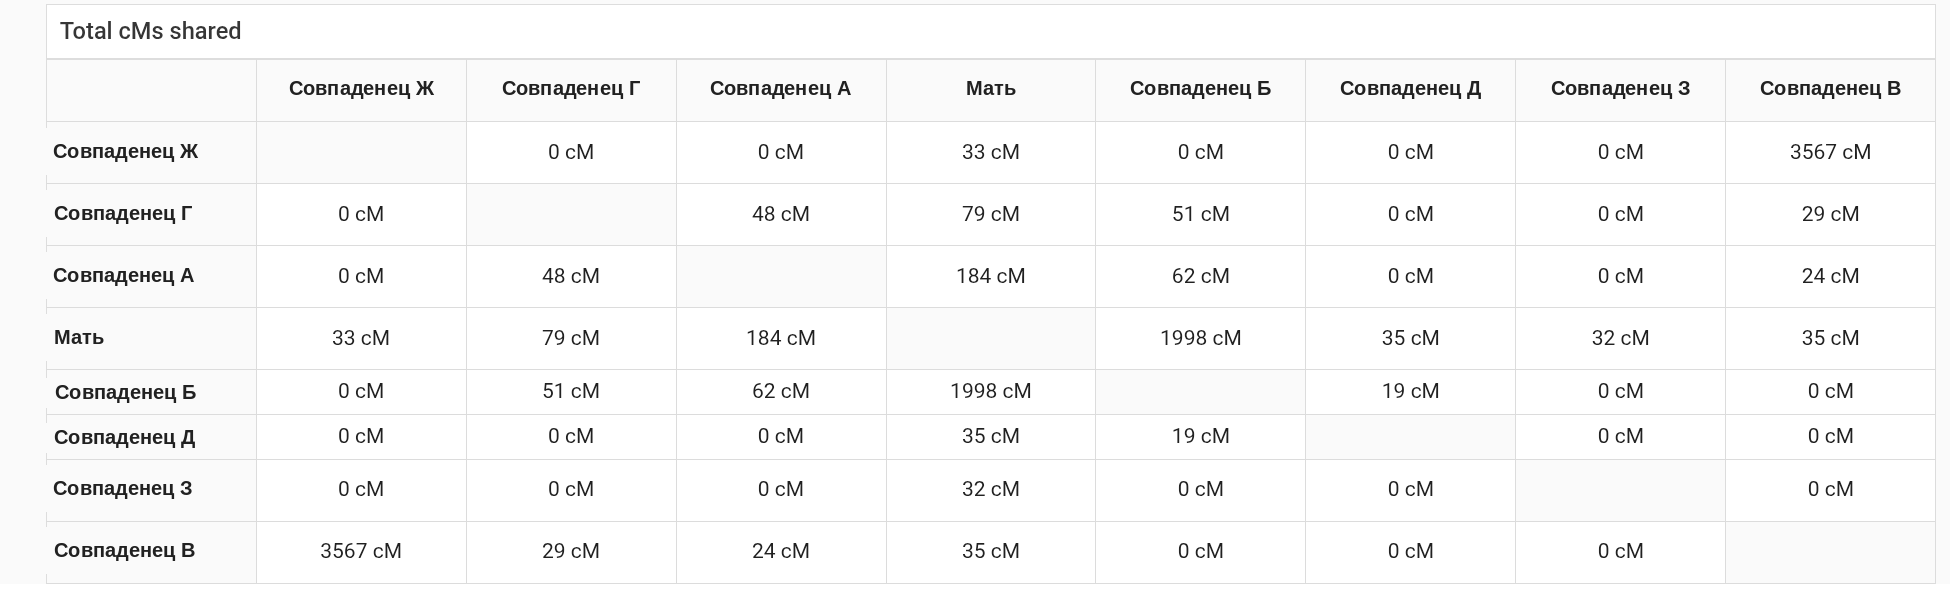
Те же числа таблицей, чтобы не вглядываться в скриншот (в сМ; по диагонали — пусто):
| Мать | А | Б | В | Г | Д | Ж | З | |
|---|---|---|---|---|---|---|---|---|
| Мать | — | 184 | 1998 | 35 | 79 | 35 | 33 | 32 |
| А | 184 | — | 62 | 24 | 48 | 0 | 0 | 0 |
| Б | 1998 | 62 | — | 0 | 51 | 19 | 0 | 0 |
| В | 35 | 24 | 0 | — | 29 | 0 | 3567 | 0 |
| Г | 79 | 48 | 51 | 29 | — | 0 | 0 | 0 |
| Д | 35 | 0 | 19 | 0 | 0 | — | 0 | 0 |
| Ж | 33 | 0 | 0 | 3567 | 0 | 0 | — | 0 |
| З | 32 | 0 | 0 | 0 | 0 | 0 | 0 | — |
Читается по строкам. Что видно сразу:
- Мать × Совпаденец Б — 1998 сМ. Огромная величина: по таблице из раздела 5 это уровень «дядя-тётя / племянник, полусибсы, дед-внук». Со мной у Б — 979 сМ, то есть уровень двоюродных. Одно с другим согласуется единственным образом: Б — родственник по матери, и почти всё, что у нас с ним общего, пришло через неё. Так и есть: Б — сын брата моей матери, то есть для неё племянник, а для меня двоюродный брат. Пара чисел 1998 / 979 описала эту конструкцию целиком.
- Мать × Совпаденец А — 184 сМ. А со мной делит 1228 сМ. Если бы А был родственником с материнской стороны, он не мог бы делить со мной в семь раз больше, чем с самой матерью. Значит, А — с отцовской стороны; он мой двоюродный брат по отцу. А оставшиеся 184 сМ с матерью — отдельная история, к ней вернёмся в разделе 12.
- Совпаденец Ж × Совпаденец В — 3567 сМ. Знакомое число из раздела 2: эти двое друг другу родитель и ребёнок. Я об этом не знал; матрица показала.
- Ноли. Совпаденец Д делит хоть что-то только с матерью (35 сМ) и с Б (19 сМ), с остальными пятью — ровно 0 сМ. Совпаденец З — 32 сМ с матерью и нули со всеми.
Вывод, который стоит того, чтобы его выделить:
Сторона родства определяется без единого документа. Достаточно, чтобы протестировался один родитель. Все, кто делит много с матерью, — материнские; все, кто делит с вами много, а с ней мало, — отцовские.
Обратная сторона: если родители не тестировались, матрица даёт только группы («эти четверо между собой родня, а вон те трое — другая компания»), но не говорит, какая группа чья.
8. In Common With
В карточке каждого совпаденца есть меню с двумя пунктами:
- In Common With — показать тех моих совпаденцев, кто совпадает и с этим человеком тоже;
- Not In Common With — наоборот, тех, кто с ним не совпадает.
Это та же идея, что в матрице, но развёрнутая на весь список, а не на выбранную восьмёрку. Обычный рабочий приём: взять заведомо известного родственника по отцу и посмотреть его ICW-список — там будет отцовская родня.
Ловушка ровно одна, и она вылезает при эндогамии: «общий с обоими» не значит «родня по одной линии». Если село маленькое и все переженились между собой, ICW-список превращается в список села.
9. X-совпадение
Колонка, которая иногда называет сторону родства сразу и без матрицы — но пользоваться ею надо аккуратнее, чем обычно пишут.
X-хромосома передаётся не как аутосомы:
- мужчина получает X только от матери (от отца ему достаётся Y);
- женщина получает X от обоих родителей;
- отец передаёт свою единственную X всем дочерям и ни одному сыну.
Из последнего пункта следует главное: в родословной X любой шаг «отец → сын» обрывает путь. Родословная X — не всё дерево, а его узкое подмножество.
Для мужчины отсюда получается верное и жёсткое правило: любое совпадение по X пришло через мать. Отцовской X у мужчины нет физически.
Мои цифры (я мужчина):
| Кто | X Match |
|---|---|
| Мать | 181 сМ |
| Совпаденец Б — сын брата моей матери | 39 сМ |
| Совпаденец А — сын сестры моего отца | нет |
181 сМ у матери — это полная длина X-хромосомы на карте FTDNA: моя единственная X пришла от неё целиком.
Строка, которой не должно быть
Теперь посчитаем, что должно стоять у Совпаденца Б.
Б — сын брата моей матери. Б получил X от своей матери, то есть от жены моего дяди. А сам дядя — брат моей матери — сыну X не передавал вовсе. Значит, наше двоюродное родство идёт по пути, в котором есть шаг «отец → сын», и по X этот путь закрыт.
Иначе говоря: из того, что Б мой двоюродный брат по матери, X-совпадения не следует. Там должен стоять ноль.
Стоит 39 сМ.
Объяснение простое, и оно не про двоюродное родство: мать Б — тоже дальняя родня моей матери. Село одно, там все друг другу родня в той или иной степени. Двоюродным братом Б мне приходится по линии дяди, а X пришла совсем с другой стороны — по линии двух женщин, которые между собой седьмая вода.
У Совпаденца А сходится проще: он сын сестры моего отца, его X — от его матери, то есть от сестры моего отца, а мне от отца X не досталось. Общей X-родословной нет, и в колонке честный «No Match».
Вывод, который стоит запомнить. X-совпадение у мужчины действительно указывает на материнскую сторону — это верно всегда. Но оно не указывает на конкретного материнского родственника, о котором вы подумали. Прежде чем строить вывод, нарисуйте путь X и вычеркните из него все шаги «отец → сын». Если после этого путь исчез, а совпадение есть — значит, родство идёт ещё и по другой линии, не по той, о которой вы подумали.
Ещё две оговорки:
- Отсутствие X-совпадения не доказывает ничего. Материнский родственник запросто может не делить с вами X: она одна, и по ней легко «промахнуться».
- У женщин правило не работает вовсе. X у них две, одна от отца, — и совпадение может прийти с любой стороны.
X-совпадения можно отобрать отдельно
X у FTDNA — не просто колонка в карточке. В выпадающем списке над списком совпаденцев есть пункт X-Matches:
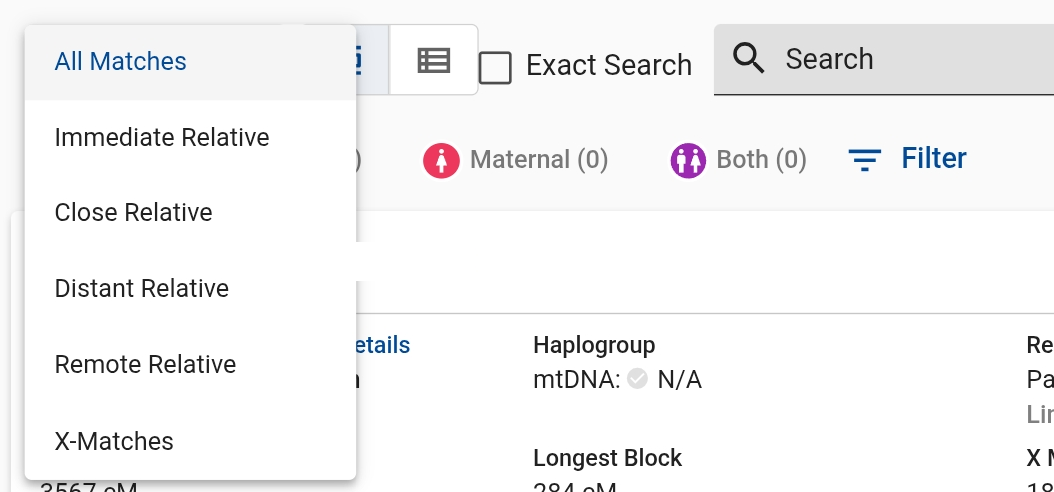
Такой же режим есть и у матрицы из раздела 7: сравнение «все со всеми» переключается на X.
Вот что он выдаёт у меня:
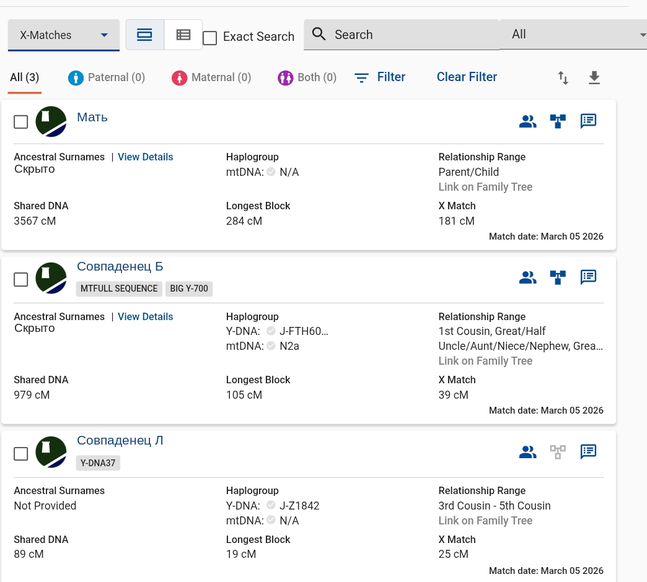
Три человека из 496. Мать (181 сМ), Совпаденец Б (39 сМ) и Совпаденец Л (25 сМ) — новое лицо, в разборе до сих пор не встречавшееся: 89 сМ по аутосомам, диапазон «3C – 5C».
Три из четырёхсот девяноста шести — это норма, а не бедность выборки. X одна, она короткая, и половина путей в родословной для неё закрыта.
Как это выглядит на самой X
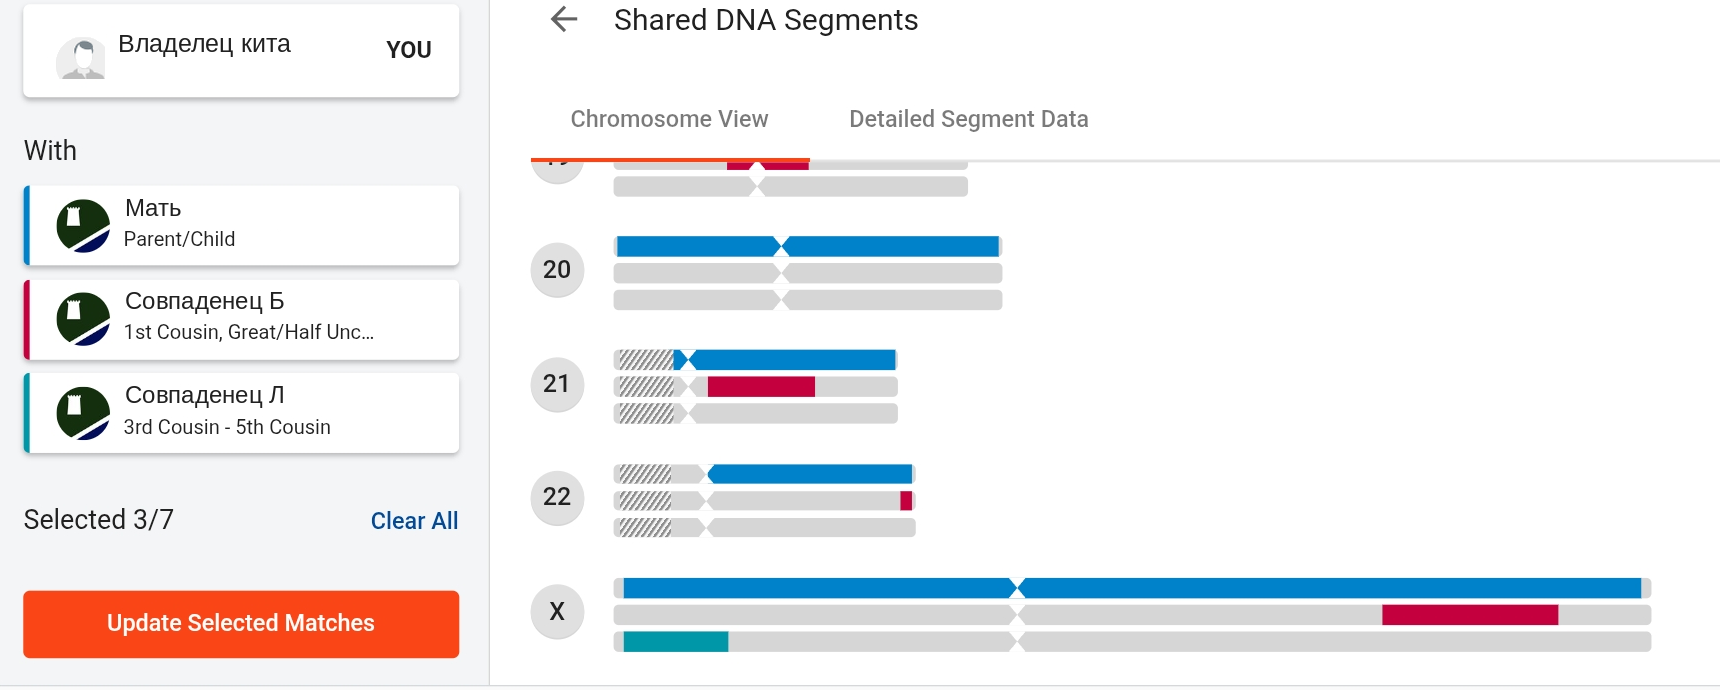
В браузере X идёт последней, после 22-й хромосомы. У Матери она закрашена от края до края — вся моя X пришла от неё. У Совпаденца Б общий кусок справа, у Совпаденца Л — слева, и они не пересекаются: это два разных родства, а не одно.
10. SNP-poor участки и фантомные совпаденцы
Теперь самое интересное: почему в списке столько людей, с которыми у вас нет ничего общего.
Что такое штриховка на хромосоме
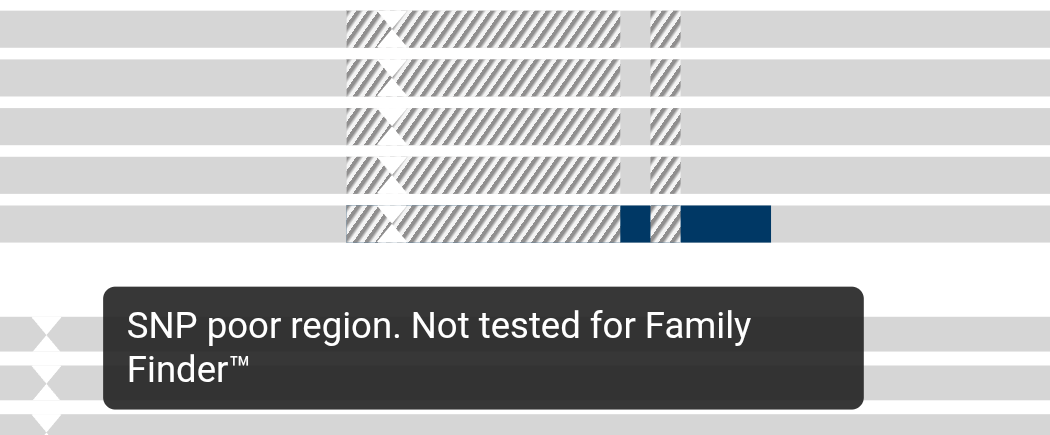
На полосках хромосом есть заштрихованные участки. Подсказка объясняет прямо: «SNP poor region. Not tested for Family Finder™» — участок беден выбранными позициями и в тесте не проверяется. Чип туда не смотрит.
Такие зоны — это в основном районы центромер и повторов, которые плохо читаются любыми чиповыми технологиями.
Семеро неродственников в одной точке
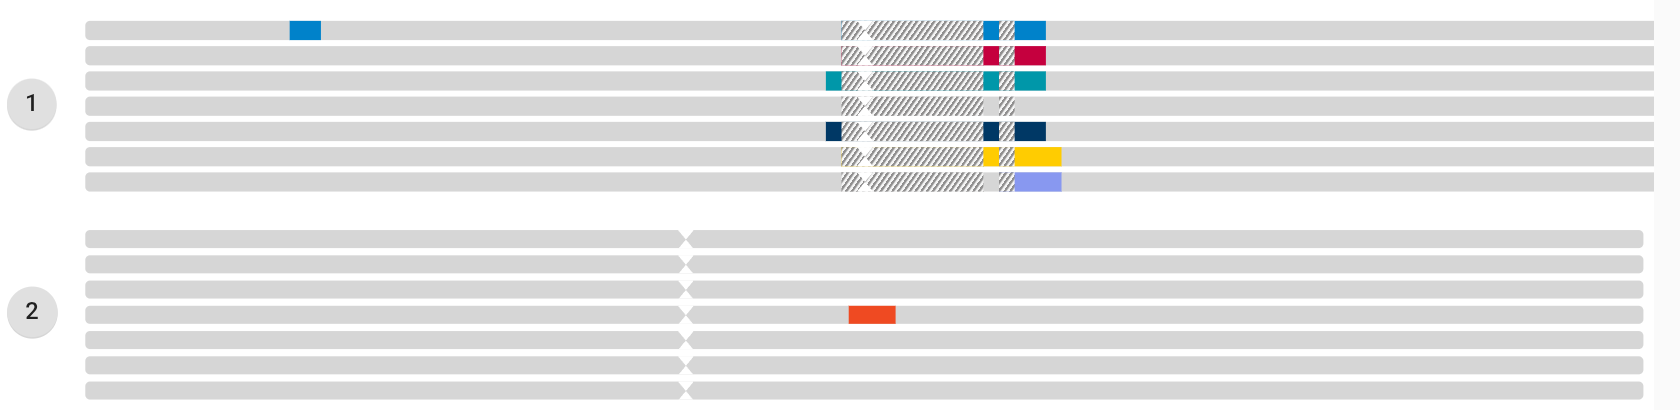
Здесь выбраны семь моих совпаденцев уровня 4th Cousin – Remote — по именам и заявленным странам это жители Скандинавии, Британии и США, к Дагестану отношения не имеющие. И картинка получается странная: их общие со мной куски собрались почти все в одном месте первой хромосомы, прямо у края штриховки.
Причём собрались не абы где. Шестеро из семи имеют кусок сразу за серой зоной, пятеро — ещё и в узком просвете между двумя штриховками, двое — впритык к штриховке слева. Единственный сегмент, лежащий сам по себе, в стороне от всякой серой зоны, есть ровно у одного человека из семи.
Почему так выходит
Алгоритм ищет длинные участки, где у двух людей совпадают все прочитанные позиции. Рядом с зоной, где позиций почти нет, «все прочитанные позиции» — это горстка точек. Совпасть по горстке точек можно и без всякого родства, просто потому что вариант распространённый. Алгоритм видит длинный (в мегабазах!) участок без единого расхождения и объявляет сегмент.
Такие места в генетической генеалогии называют зонами избыточных совпадений, или pile-up. Совпадение в них — identical by state, «одинаково по состоянию», а не identical by descent, «одинаково по происхождению». Общего предка за ним нет.
Правило, которое стоит запомнить
Сегмент, прижатый к серой зоне, — почти наверняка фантом. Особенно если других общих кусков с этим человеком нет вовсе.
Проверяется за минуту и без всяких вычислений: отметьте разом десяток дальних совпаденцев и посмотрите на картинку. Выстроились столбиком у одного и того же края штриховки — это не родня, а артефакт разметки чипа.
По-хорошему такие зоны стоило бы расширять с запасом и сегменты внутри них не засчитывать вовсе — тогда список совпаденцев не засорялся бы сотнями людей, с которыми у вас нет ничего общего. В исследовательских программах так и поступают — подозрительные участки маскируют (Li et al., 2014). В списке FTDNA, судя по моим семи совпаденцам, их по-прежнему засчитывают, и отсеивать приходится глазами.
11. Одна пара, три лаборатории
Совпаденец К сдавал тест и в FTDNA, и в российском Генотеке; я — тоже, и вдобавок мы оба залили сырые данные на GEDmatch. То есть одна и та же пара людей промерена трижды. Такое сравнение стоит подороже любых рассуждений о точности.
Что показывает FTDNA
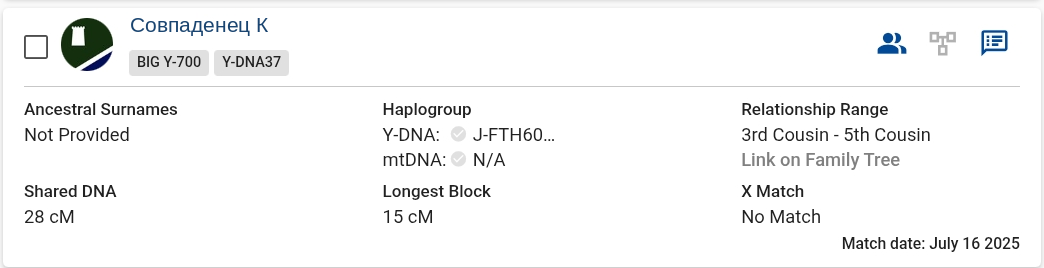
28 сМ суммарно, длинный блок 15 сМ, диапазон 3rd Cousin – 5th Cousin, X-совпадения нет.
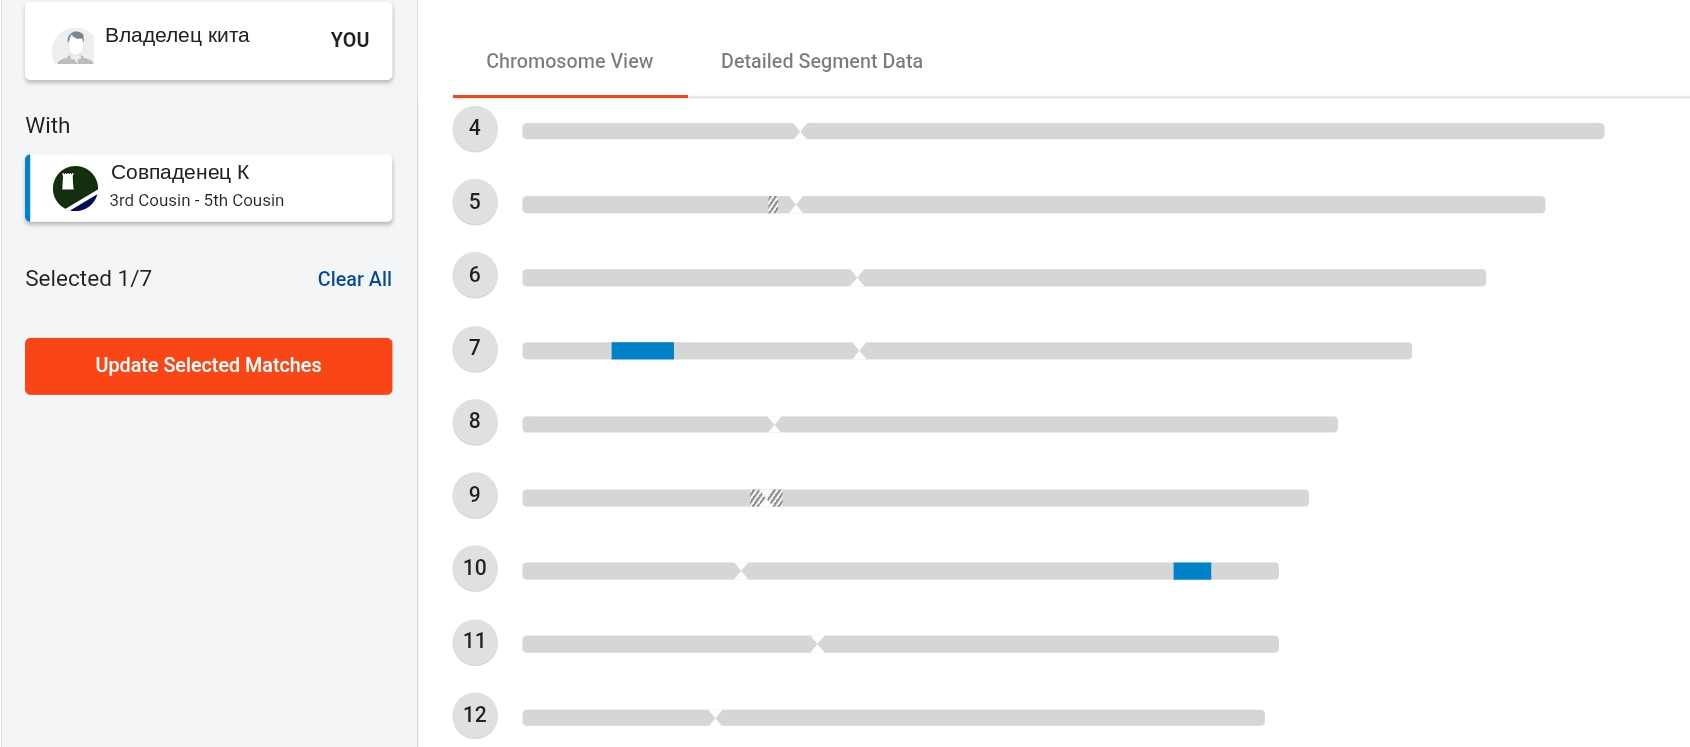
В браузере два куска: один на хромосоме 7, второй на хромосоме 10. Остальные хромосомы в этом диапазоне (4, 5, 6, 8, 9, 11, 12) пусты.
Что показывает Генотек
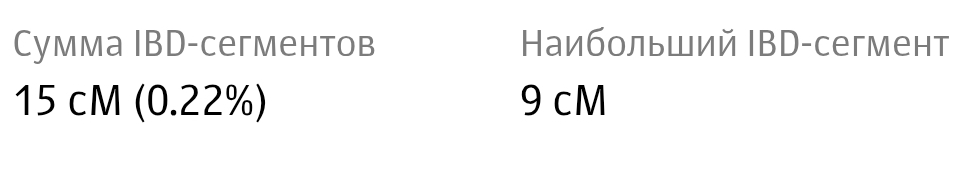
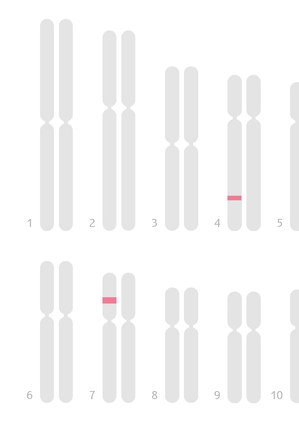
15 сМ суммарно (0,22 % генома), наибольший IBD-сегмент — 9 сМ. На схеме хромосом закрашены хромосома 4 и хромосома 7.
Что показывает GEDmatch
GEDmatch — не лаборатория, а площадка: туда загружают сырые файлы из любых компаний и сравнивают между собой. Мы загрузили оба.
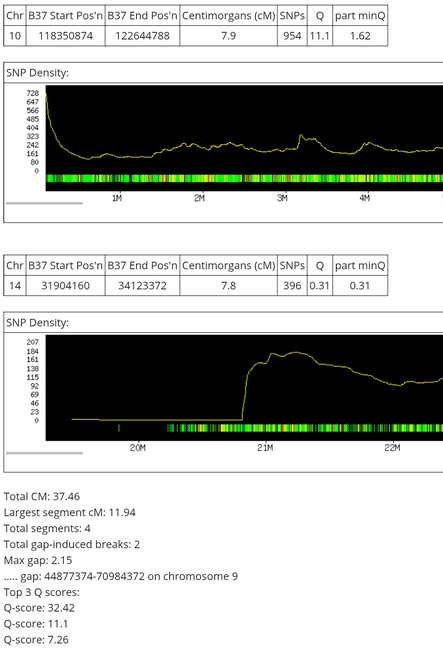
37,46 сМ суммарно, наибольший сегмент 11,94 сМ, всего четыре сегмента. Из показанных на скриншоте — хромосома 10 (118,4–122,6 Мб, 7,9 сМ, 954 SNP) и хромосома 14 (31,9–34,1 Мб, 7,8 сМ, 396 SNP).
Здесь же видно то, чего не показывают кабинеты компаний. Под каждым сегментом — график плотности SNP, а в таблице колонка SNPs: сколько позиций реально прочитано на этом участке. 954 позиции на 4,3 мегабазы и 396 на 2,2 мегабазы — негусто, и по правилу из раздела 10 такие сегменты сразу попадают в кандидаты на фантомы. GEDmatch честно печатает и дырки в данных: «gap: 44 877 374–70 984 372 on chromosome 9».
И ещё одно отличие: порог в сравнении один-к-одному задаёте вы сами. Поставите ниже — сегментов станет больше, сумма вырастет. Так что 37,46 сМ — это не «правильное» число, а число при выбранном пороге.
Свод
| FTDNA | Генотек | GEDmatch | |
|---|---|---|---|
| Сумма общего | 28 сМ | 15 сМ | 37,5 сМ |
| Наибольший сегмент | 15 сМ | 9 сМ | 11,9 сМ |
| Число сегментов | — | — | 4 |
| Где нашлись сегменты | хр. 7, 10 | хр. 4, 7 | хр. 10, 14 и ещё два |
Одни и те же два человека, одна и та же ДНК — и суммы отличаются в два с половиной раза. Совпадений между сервисами по местам тоже негусто: хромосому 7 нашли FTDNA и Генотек, хромосому 10 — FTDNA и GEDmatch, хромосому 4 — только Генотек, хромосому 14 — только GEDmatch.
Почему так
- Разные чипы. Компании читают разные наборы SNP. Там, где у одной плотность позиций выше, она увидит сегмент, который другая пропустит, — и наоборот.
- Разные генетические карты. Перевод физических координат в сантиморганы делается по карте рекомбинации, и карты у всех разные. Даже физически один и тот же кусок получит разное число сМ.
- Разные пороги и разные алгоритмы. Минимальная длина сегмента, минимальное число SNP в нём, способ фазирования, обработка «шумных» зон — всё это настраивается по-своему.
- Разные политики по мелочи. Одна компания складывает в сумму всё подряд, другая отбрасывает короткие куски.
Что из этого следует практически
- Цифру сМ нельзя переносить между сервисами. Таблицу из раздела 5 применяйте к цифре той компании, в чьём кабинете вы её увидели, а не к пересчитанной на глаз.
- Согласие двух методов сильнее большого числа у одного. Хромосому 7 нашли независимо FTDNA и Генотек, хромосому 10 — FTDNA и GEDmatch; вот это довод. Сегменты, которые видит ровно один сервис, надо держать за гипотезы.
- Сравнивать надо сегменты, а не суммы. Сумма — производная от порогов и алгоритма, координаты сегмента — нет.
И отдельно про Y
По мужской линии мы с Совпаденцем К сидим в одной ветке Y-дерева. Возраст ветки — около 1200 лет, плюс-минус четыреста. По женской линии расходимся: у меня T2h, у него U4d.
Три теста отвечают на три разных вопроса, и смешивать их ответы нельзя. Аутосомы дали «3C – 5C» и три несогласные оценки. Y говорит, что общая линия отцовская, а общий предок по ней жил около тысячи лет назад — то есть глубже, чем предполагает аутосомный диапазон. Митохондриальные линии разные: по прямой женской линии родства нет вовсе.
Как читать возраст ветки на Y-дереве и почему у него такой разброс — в справочнике «Как читать дерево FamilyTreeDNA».
12. Эндогамия и малые народы
Всё вышесказанное сдвигается, если население, из которого вы происходите, столетиями женилось внутри себя. Дагестанское село — ровно такой случай.
Признак первый: совпаденцев мало
У меня их 496. Для сравнения: у среднего американца европейского происхождения в базе FTDNA их обычно тысячи. Причина не в биологии, а в том, сколько соседей дошло до лаборатории: дагестанцев в базе мало.
Это стоит проговорить отдельно, потому что вывод из «мало совпаденцев» делают неверный. Мало совпаденцев — это дырка в данных, а не свойство популяции.
Признак второй: чужие люди делят слишком много
Вернитесь к матрице из раздела 7. Совпаденцы Г, Д, В, З между собой — не родственники в любом обозримом смысле, никто из них не знает остальных. И тем не менее:
- Мать × Г — 79 сМ
- Мать × Д — 35 сМ
- Мать × З — 32 сМ
- Г × В — 29 сМ
- А × В — 24 сМ
- А × Мать — 184 сМ
Последняя строка — самая показательная во всём справочнике. А — мой двоюродный брат по отцу, сын сестры моего отца. С моей матерью он не в родстве вообще: она вошла в эту семью со стороны. В неэндогамной семье в этой клетке должен стоять ноль — ну или пара десятков сМ случайного фона.
Стоит 184 сМ. По таблице из раздела 5 это уровень троюродных. Искать тут «двоюродного дедушку» не надо: мои родители сами друг другу дальняя родня, как почти любая пара из одного села.
Та же причина объясняет и цифру из раздела 5. Двоюродный брат по отцу делит со мной 1228 сМ при среднем для двоюродных 866 — потому что общих предков у нас не одна пара, а несколько, и каждая добавляет своё. Родство названо верно, а вот величина завышена.
Признак третий: лишние связи вылезают там, где их не ждёшь
Самый недооценённый эффект. Эндогамия не просто раздувает числа — она дорисовывает вторые пути родства между людьми, у которых уже есть один известный путь.
Ровно это случилось с X-хромосомой в разделе 9. Двоюродное родство с Совпаденцем Б идёт через брата моей матери, а по этому пути X передаваться не может в принципе. X-совпадение всё равно есть — 39 сМ, — потому что его мать — тоже дальняя родня моей матери. Одно село.
Практическое следствие неприятное: в эндогамной выборке «второй путь» есть почти всегда, и он невидим. Вы измеряете сумму двух родств, а думаете, что измеряете одно.
Сколько именно: родство родителей можно измерить
У GEDmatch есть отчёт «Are Your Parents Related?». Он ищет ROH — runs of homozygosity, участки, где обе копии хромосомы у вас одинаковы. Если родители друг другу никто, таких участков практически нет: копии пришли из разных семей и различаются. Если родители в родстве — вы получаете от них один и тот же кусок дважды.
У меня набралось 43 сМ таких участков. Дальше инструмент переводит эту величину в вероятности родства между родителями:
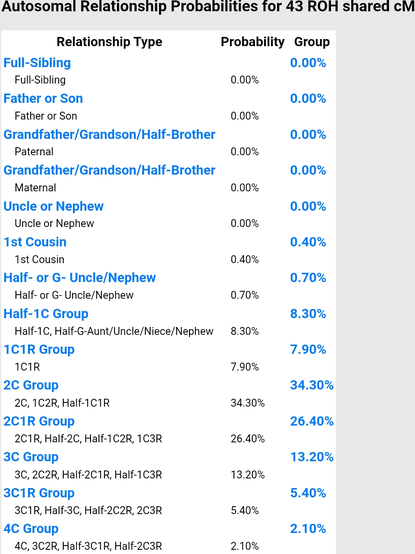
Самые вероятные варианты — 2C (34,3 %), 2C1R (26,4 %), 3C (13,2 %).
Ничего нового мне тест здесь не сообщил: мои родители — троюродная тётя и племянник, и в семье это знали всегда. Для села такое родство — обычное дело, а не история. Ценно другое: заранее известный ответ встал ровно на вторую строку таблицы. То есть инструмент проверен на случае, где ответ был известен заранее, — и уже поэтому его показаниям можно верить там, где ответа нет.
Порядок величины сходится тоже. Для пары 2C1R ожидаемая доля генома, полученная от общего предка дважды, — около 0,8 %; 43 сМ от карты в 7134 сМ — это 0,6 %. Разница в ту сторону, в какую и должна быть: короткие участки инструмент не ловит.
Заодно эта величина даёт числовое объяснение сразу трём странностям из предыдущих разделов:
- почему двоюродный брат по отцу делит с моей матерью 184 сМ — они родня через саму эту пару;
- почему два двоюродных брата с разных сторон, А и Б, делят между собой 62 сМ, хотя общего у них вроде бы не должно быть ничего;
- почему суммы у обоих выше среднего для двоюродных.
То есть это не догадка про «какие-то вторые пути», а измеренная величина: родители в родстве на уровне троюродных, и эта добавка сидит в каждой цифре.
Что из этого следует для чтения цифр
Таблицу из раздела 5 нельзя применять напрямую. Проект Shared cM Project собирает данные с прямым вопросом «есть ли в этой паре эндогамия или брак между родственниками» и такие пары отделяет. То есть таблица описывает популяции без эндогамии — а у нас она есть.
Смещение всегда в одну сторону: сумма сМ завышает близость родства. Троюродный из соседнего квартала показывает столько же, сколько двоюродный в неэндогамной выборке, потому что общих предков у вас не один, а десяток, и каждый добавляет по кусочку.
Что делать вместо этого:
- Смотреть на длинный блок, а не на сумму. Много общих предков дают много мелких кусков; один близкий предок даёт один длинный. При 200 сМ суммы длинный блок 90 сМ и длинный блок 20 сМ — это два совершенно разных родства.
- Смотреть на число сегментов. Тридцать кусков по 7 сМ и три куска по 70 сМ дают похожую сумму и разное родство.
- Считать сдвиг эмпирически. Если в вашей выборке есть пары с документально известным родством (как у меня — мать и оба двоюродных брата), можно прикинуть, насколько цифры завышены именно у вас, и дальше держать поправку в уме.
- Не строить генеалогию на одной сумме. Нужен либо длинный блок, либо подтверждение с другой стороны — матрица, ICW, Y или мтДНК.
Косвенное признание проблемы есть у самой FTDNA: её алгоритм оценивает эндогамию и с её учётом решает, кого показать в списке и какое родство подписать (раздел 3). Но сумму сМ он не исправляет. В описании алгоритма названы ашкеназы, индейцы, полинезийцы и финны. Дагестанцев, чеченцев и кабардинцев в этом списке нет, и поправку на них приходится держать в голове самому.
13. Этнические разбивки: myOrigins, Генотек и что за ними стоит
Отдельная вкладка, ради которой тест часто и покупают: разложение происхождения по процентам. Разбирать её надо вместе с совпаденцами, потому что делается она из тех же данных и ломается по тем же причинам.
Как это устроено
Алгоритм сравнивает ваш геном с референсными панелями — наборами людей, про которых считается, что они «эталонно» представляют ту или иную популяцию, — и подбирает такую смесь панелей, которая лучше всего объясняет вашу ДНК.
Ключевое слово — «объясняет». Процент в отчёте означает не «столько во мне такой крови», а «такую долю моего генома модель сумела объяснить через вот эту референсную группу». Свойство это не столько ваше, сколько панели.
Та же ДНК, два сервиса
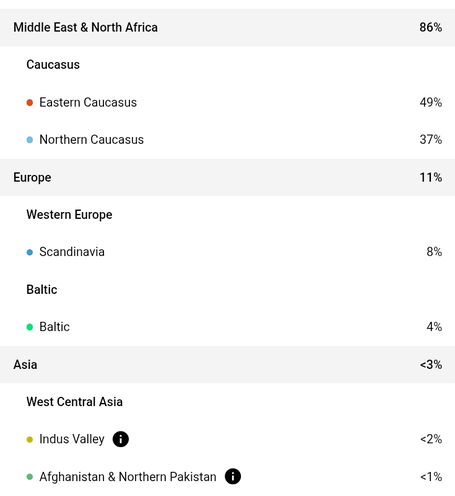
FTDNA, myOrigins версии 3, 90 референсных популяций:
| Регион | Доля |
|---|---|
| Middle East & North Africa | 86 % |
| — Eastern Caucasus | 49 % |
| — Northern Caucasus | 37 % |
| Europe | 11 % |
| — Scandinavia | 8 % |
| — Baltic | 4 % |
| Asia | <3 % |
| — Indus Valley | <2 % |
| — Afghanistan & Northern Pakistan | <1 % |
Кавказ на месте: 86 % разложились на восточно- и северокавказские кластеры. А дальше — 8 % Скандинавии и 4 % Балтики у человека, у которого все известные предки из одного дагестанского села.
Теперь тот же человек в Генотеке:
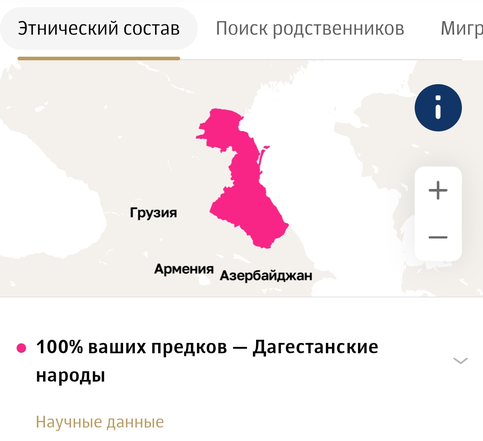
100 % — дагестанские народы. Ни Скандинавии, ни Балтики.
Почему расходятся
Дело не в том, что кто-то «точнее». Дело в панели.
У Генотека есть подробная панель по народам России, и дагестанцы в ней — отдельный кластер. Хорошо видно на их же графике главных компонент:
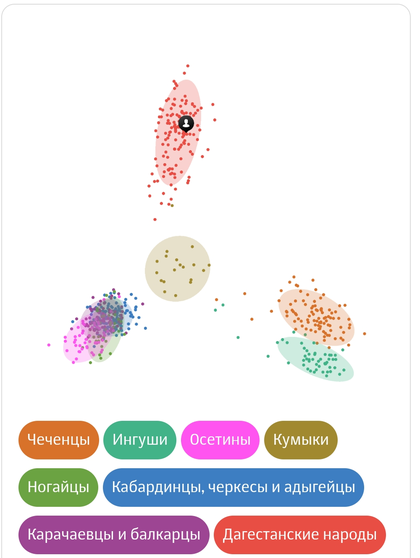
Каждое облако — отдельный народ: чеченцы, ингуши, осетины, кумыки, ногайцы, кабардинцы-черкесы-адыгейцы, карачаевцы-балкарцы и дагестанские народы. Моя точка сидит внутри дагестанского облака, и это облако лежит заметно в стороне от всех остальных кавказских.
Теперь представьте ту же задачу без дагестанской панели. Модель обязана разложить геном по тем группам, которые у неё есть. Основное уедет в ближайшие доступные кавказские кластеры, а остаток, который ни на что толком не похож, растечётся по случайным группам — так и появляются 8 % Скандинавии.
Отсюда правило:
Проценты меняются при смене панели, хотя ДНК не менялась. Разбивка описывает не вас, а расстояние от вас до чужой коллекции образцов.
G25, qpAdm и древние компоненты
За пределами коммерческих кабинетов есть слой любительских и научных инструментов, и путать их не надо.
G25 (Global25) — набор координат: ваш геном пересчитывается в точку 25-мерного пространства главных компонент, и в этом же пространстве лежат тысячи современных и древних выборок. Дальше поверх координат подбирают модель смеси (nMonte, Vahaduo и подобные). Важно понимать: G25 — не тест и не результат, а система координат. Подбор выдаёт «лучшую смесь из того, что вы предложили», и если правильных источников в списке нет, он всё равно выдаст красивый ответ из неправильных.
Тема большая и в этот справочник не помещается. Кому интересно посчитать свои координаты — ищите статью «Инструкция по G25 координатам и Vahaduo»; понадобится файл сырых аутосомных данных, тот же, что грузят на GEDmatch.
qpAdm (пакет ADMIXTOOLS) — инструмент из научного обихода. Он не подбирает проценты «на глазок», а проверяет гипотезу: «целевую популяцию можно представить как смесь вот этих источников» — и выдаёт долю каждого плюс p-value, то есть формальный ответ, отвергается модель или нет. Это строже G25, но и здесь результат зависит от набора «правых» (сравнительных) популяций: с одним набором модель проходит, с другим — рассыпается. Читая чужой qpAdm-результат, всегда смотрите, какие источники и какие правые группы взяты.
Древние компоненты — «ямная», «анатолийские земледельцы», кавказские охотники-собиратели (CHG), восточные охотники-собиратели (EHG) — это тоже модели, а не измерения. Утверждение «во мне 40 % CHG» означает «выбранная модель с выбранными источниками положила 40 % на выборку, которую назвали CHG». Смените набор источников — изменится и число.
Чего разбивка не говорит
- Не говорит национальность. Она сравнивает с современными выборками, у которых есть свои названия, — и всё.
- Не говорит о «чистоте». 100 % в одном сервисе и 86 % в другом — это про панели, а не про предков.
- Не переводится в родословную. Процент — не «прапрадед оттуда»; он не привязан ни к какому конкретному предку.
- Мелкие доли — шум. Всё, что ниже нескольких процентов, надо читать как «модель не смогла объяснить этот кусок ничем лучше».
- Пересчитывается при обновлениях. Смена версии панели меняет проценты у всех разом; myOrigins в этом смысле не исключение.
14. Чего Family Finder не говорит
- Сумма сМ не называет родство. Она называет диапазон, и диапазоны соседних родств перекрываются.
- Отсутствие совпадения не означает отсутствия родства. У 3C и дальше минимум по таблице — ноль.
- Наличие совпадения не означает наличия родства. У дальних «совпаденцев» сегмент часто лежит в зоне избыточных совпадений (раздел 10).
- Relationship Range — не диагноз. Три моих совпаденца с 63, 52 и 46 сМ подписаны одинаково.
- Ancestral Surnames и страна — самозаявленные. Это то, что человек про себя думает, а не то, что показала ДНК.
- Family Finder не говорит, по какой линии родство, пока вы не привяжете известную родню к дереву или не разведёте стороны руками (разделы 7 и 9).
- Эндогамия не отмечается никак. Цифры выглядят точно так же, только означают другое родство.
- X-совпадение не называет конкретного предка. Оно говорит только, что путь идёт через мать и не содержит шагов «отец → сын» (раздел 9).
- Сумма сМ — не свойство пары людей, а свойство лаборатории. У одной и той же пары 28 сМ в FTDNA и 15 сМ в Генотеке (раздел 11).
- Проценты происхождения — не про вас, а про референсную панель. 8 % Скандинавии в одном сервисе и 0 % в другом при одной и той же ДНК (раздел 13).
- Совпаденец — не предок и не потомок. Все, кто есть в списке, — ваши боковые родственники.
15. Чеклист при разборе совпаденца
- Посмотреть Longest Block, а не только сумму. Длинный блок — сильнее суммы.
- Открыть хромосомный браузер: где лежат общие куски и сколько их. Если рисовать нечего — дальше не идти.
- Проверить, не собрались ли сегменты в одну и ту же точку у многих дальних совпаденцев разом. Если да — это зона избыточных совпадений, а не родня.
- Проверить X Match. Есть X-совпадение и вы мужчина — родство материнское. Но прежде чем назначать конкретного предка, нарисовать путь X и вычеркнуть шаги «отец → сын». Нет совпадения — не следует ничего.
- Прогнать через матрицу вместе с уже известной роднёй: нули и большие числа разложат людей по сторонам.
- Открыть In Common With и посмотреть, в какую компанию человек попадает.
- Сверить сумму с таблицей диапазонов — и, если в вашей выборке есть эндогамия, помнить, что сумма завышена.
- Если человек есть в другой лаборатории — сравнить не суммы, а сегменты. Совпал сегмент в обеих — он настоящий.
- Загрузить сырые данные на GEDmatch. Там и куча калькуляторов, и, главное, совпаденцы из разных лабораторий в одной базе: человек, сдавший в другой компании, в вашем списке на FTDNA не появится никогда.
Источники
- FamilyTreeDNA. Family Finder Matching 5.0: Matching Algorithm and Relationship Estimation. White paper, 18 августа 2021 г. — нынешние пороги, отсечка кусков короче 6 сМ, оценка эндогамии, ложные совпадения по состоянию (IBS).
- Bettinger B. Family Tree DNA Updates Matching Thresholds. The Genetic Genealogist, 24 мая 2016 г. — пороги 2016 года и прежние.
- Bettinger B. Version 4.0! March 2020 Update to the Shared cM Project. The Genetic Genealogist, 27 марта 2020 г. — таблица из раздела 5.
- Li H. et al. Relationship Estimation from Whole-Genome Sequence Data // PLoS Genetics. 2014. Vol. 10, № 1. — участки генома с избыточными ложными совпадениями и как их исключать.
- FamilyTreeDNA. MyHeritage Brings Its Family Tree Tools to FamilyTreeDNA. Блог FTDNA, 2024 г. — закрытие собственного редактора дерева 9 сентября 2024 г.